1996年7月5日複製羊桃麗(Dolly)複製成功,分子生物技術達到一個成功的高潮,複製羊變成活的製藥廠的夢想有可能成真了。到了今年年初
(1998年1月)美國芝加哥的科學家席德,提出開設複製人診所的想法,對科學、人文、倫理、宗教、社會各界投下了超級大炸彈,生物倫理學(bioethics)成為最近最熱門的討論課題之一[1]。一時之間,基因複製、基因治療、人類基因組解讀計劃(Human
Genome
Project)又成為大家目光集中的焦點。為了完成這個生物學家口中的“登月計劃”,美國國家衛生研究院(NIH)於1989年成立了人類基因組研究中心,邀請華森(James
D. Watson)教授(DNA雙螺旋結構的發現者之一)為第一任中心主任,計劃在西元2005年解讀完人類遺傳密碼的三十億個DNA序列[2]。
當科學家手上有了三十億個DNA序列的龐大生物資料庫之後,生物學家再也不可能用傳統的紙上作業的方法去解讀這些資料,必須依靠電腦的高速計算能力才有可能對這筆龐大的資料進行整理與分析。因此結合了分子生物學、生物物理學、統計數學、計算機科學…等跨領域的專家們紛紛投入這方面的研究,整合出一個新興的研究領域-生物資訊學(Bioinformatics)與計算生物學(Biocomputing,Computational
Biology)。
圖一 分子生物學與計算機科學結合,產生了計算生物學。(圖摘錄字參考資料2)
在人類基因組解讀計劃的推動之下,決定DNA序列的實驗技術有了重大的突破,基因資料庫的資料正以指數的速率快速地成長(以GCG的資料庫為例,1997年8月的97-5版資料量是8.04GB,1998年3月的98-2版資料量已經膨脹到10.l5GB了)。在此同時利用X-ray繞射法決定蛋白質晶體結構,有同步輻射提供更強的光源;利用核磁共振決定蛋白質在液體中的結構,也有同位素標定的三維,甚至四維的光譜技術突破,於是蛋白質資料庫(例如PDB、SCOP、Swiss-Prot、PIR等)的資料量也有驚人的成長速率。所以計算生物學的課題除了基因序列的分析之外,另外一個重要的課題便是蛋白質的分析(包括三度空間的立體結構預測、蛋白質motif的分析與預測等)。原因很簡單,遺傳密碼的DNA是以一度空間的線性順序排列,而執行生化反應功能來維繫生命的是蛋白質,而蛋白質功能的正常與否,則是取決於三度空間的摺疊(folding)是否正確。
在全球網際網路-WWW上,可以發現有很多很多關於基因序列分析的網站,所以我們不再贅述,而只提供重要的DNA資料庫相關網站。在此我們將提供較多有關蛋白質分析的網站,以及網上教學、生物資訊學最新發展、相關的應用等,希望引起大家的興趣,一起遨遊在生物資訊學的領域裡。接下來將對本中心生物資訊學網頁中各節的內容做一個簡單的介紹。
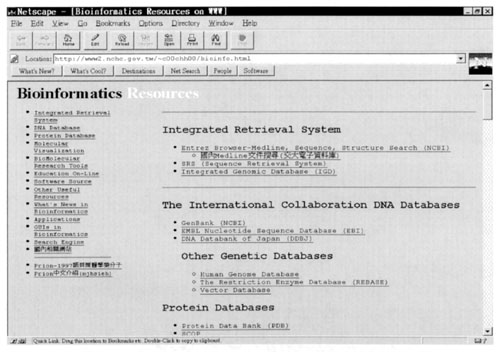
圖二 國家高速電腦中心生物資訊學資源首頁畫面。左邊欄位內容是各小節的標題;右邊是各小節所連結上的各相關網站,圖上可看到整合型資料取得系統、DNA資料庫和蛋白質資料庫的連結網站。
說明
- 整合型資料取得系統(Integrated Retrieval System)
Entrez:美國國家衛生研究院轄下NCBI的Entrez搜尋系統,對醫學文獻資料庫-Medline的搜尋是最有名的整合型資料取得系統,它不僅可以立刻取得文獻摘要,也可以得到DNA序列、蛋白質的胺基酸序列、三度空間的立體結構、生物分類學(Taxonomy)資料等重要的資訊。
SRS (Sequence Retrieval System):這是瑞士日內瓦大學所管理的ExPASy網站所發展出來的整合型搜尋系統,ExPASy所強調的服務在於與蛋白質有關的資料庫,而SRS系統便把Swiss-Prot、TREMBL、PROSITE、ENZYME等資料庫統合起來的搜尋系統。
IGD (Integrated Genomic Database):這是歐美各國合作的一個計劃,目的在發展一套資訊管理系統,將有關人類基因組研究的分子生物資料庫、分析工具,利用跨國際的網路聯結在一起。 - DNA資料庫 (DNA Database)
全球的三大DNA資料庫分別是,美國的GenBank(由NCBI管理)、歐洲分子生物實驗室聯盟的EMBL(由位於英國的EBI管理),以及日本的DDBJ (DNA Databank of Japan) [3]。這三個機構每天進行例行的資料流通,收集全球最新的研究結果,組成了國際性的基因資料庫,同時這三個組織也共同主辦二項國際性的年會-International DNA Data Banks Advisory Meeting和International DNA Data Banks Collaborative Meeting。
除了上述的三大DNA資料庫之外,美國約翰霍普金斯(Johns Hopkins)大學的人類基因組資料庫,也是一個重要的DNA資料網站,尤其是它所收集的基因組地圖的資料,國內的國家衛生研究院已經架設了一個它的鏡射網站(mirror site),網址是http://gdb.nhri.gov.tw。對於分子生物學家在實驗室的操作,下面兩個網站-限制叠資料庫(REBASE)、Vector資料庫,提供了限制叠辨認的DNA序列(recognition sequence)、切斷核酸鏈的位置(cleavage site),進入宿主所需要的vector等資訊,這些都是實驗室中進行基因工程所不可或缺的工具。 - 蛋白質資料庫(Protein Database)
PDB (Protein Data Bank):蛋白質資料銀行,收集了全世界利用核磁共振、X-ray繞射實驗技術所解出來的蛋白質和DNA的三度空間立體結構,以及理論模型結構。這個資料庫所提供的資訊是全球最重要的蛋白質結構資料來源,是所有結構生物學研究工作者,瞭解蛋白質立體結構及其功能的知識泉源[4]。主要的資訊有,原子的空間座標、蛋白質的一級結構與二級結構、以及引用的文獻出處。
SCOP (Structural Classification of Proteins):依蛋白質的結構為分類依據,以樹狀結構的分類方式 將蛋白質分成Root、Class、Fold、Superfamily、Family、Protein、Species七個層次,希望將蛋白質的三級結構與其演化之間的關係能連結起來。由於蛋白質的立體結構(structure)決定蛋白質的功能 (function),因此尋求結構與功能之間的關係(structure-function relationship)是結構生物學家重要的工作之一,而隨著蛋白質的立體結構被決定出來的數目愈來愈多,結構生物學家對蛋白質的立體結構進行比對之後,有了許多的新發現。例如,當演化的距離 (evolutionary distance)較近時,使用胺基酸序列的比對就可以得到很不錯的結果;但是演化距離遠時,一般的序列比對方法便不敷使用了,這個時候就需要使用三度空間的立體結構比對了,所以立體結構比對就好比天文物理學家有一個更大的望遠鏡,可以把宇宙看得更清楚一樣,可以看到更遠的演化關係[5,6]。
除了PDB、SCOP之外,英國的結構生物學家Christine Orengo也整理出蛋白質立體結構的分類原則,成立了CATH (Class Architecture Topology Homology)的網站(http://www.biochem.ucl.ac.uk/bsm /cath) [7];另外Dali (http://www2.ebi.ac.uk.dali/)這個網站提供蛋白質立體結構比對的服務,使用者將想要進行比對的蛋白質的原子座標,以電子郵件的方式寄給Dali,Dali便會比對PDB裡面所有的蛋白質結構,將最後的比對結果寄還給你。
ExPASy:ExPASy位於瑞士日內瓦大學,主要有六個資料庫,所強調的服務在於與蛋白質有關的資料。
(l)Swiss-Prot:提供完整的註解性(annotation)資料的資料庫,描述蛋白質的生化功能、各區域(domain)的結構與功能、轉譯成蛋白質後的修飾(post-translational modification)、突變種,等等的註解;同時Swiss-Prot也提供與其它資料庫的連線,可以連線到EMBL的DNA資料庫、PROSITE資料庫、PDB資料庫等。
(2)PROSITE:這是一個以蛋白質功能為分類基準的資料庫,資料庫內的資料包括了蛋白質的生化功能、來源、活性區域、胺基酸序列的一致性模式(consensus pattern);這個網站也提供兩個預測蛋白質功能的軟體-ScanProsite和ProfileScan,讀者輸入未知功能的胺基酸序列,進行序列比對後可以提供這段胺基酸序列可能屬於那個蛋白質家族,可能有那些功能等等的資訊。
(3)Swiss-2DPage:收集蛋白質在二維電泳膠片上特定位置的資料庫。二維蛋白質電泳膠片的原理是,利用蛋白質分子量、等電位(pI)的差異,在施予電埸的驅動力(driving force)後,會出現在電泳膠片上不同的位置。所以膠片上的兩個梯度分別是分子量和pH值。目前Swiss-2DPage提供了包括紅血球、血漿(plasma)、血小板(Platelet)、淋巴瘤(lymphoma)等十二片電泳膠片,如果你手頭上有個蛋白質,經過電泳實驗後,比對這十二片電泳膠片,若出現在相同的位置就可以由這個資料庫得知現在手上拿到的可能是什麼蛋白質。
(4)Swiss-3DImage:這個資料庫提供了蛋白質的三度空間立體結構的圖像,圖像有平面的也有立體的;同時也連線到PDB的入口,可以取得原子空間座標的資料,也可以利用分子檢視軟體-Rasmol,對蛋白質做進一步的檢視。通過連線也可以進入SCOP資料庫,和EMBL的HSSP (Homology- derived Secondary Structure of Proteins) 資料庫。
(5)ENZYME:酵素是生物體生命力的啟動機,維持生命體的新陳代謝的功能。酵素的分功非常的專業,只對特定的受質(substrate)進行催化,產生特定的產物。ENZYME這個資料庫的資料有,酵素所催化的生化反應方程式、酵素所需要的輔助因子(cofactor)、酵素在Boehringer Mannheim所提供的生化新陳代謝圖中的位置。最後它也和其他的酵素資料庫進行網路連結,也提供了Swiss-Prot的登錄號碼。這個資料庫對於生化工廠的製程(process)相信有很大的幫助。
(6)SeqAnalRef:在這個資料庫裡,讀者可以查到所有關於生物巨分子序列分析的參考資料。這些資料包括了,胺基酸與DNA的序列比對、生物巨分子立體結構模擬、序列分析的數學方法、類神經網路、各種電腦程式語言、電腦模擬、各類工作站系統…,幾乎所有計算生物學有關領域的論文資料都收集到了。
在蛋白質資料庫的網站收集裡,我們也收集了在美國喬治城大學,由國家生物醫學研究基金會(National Biomedical Research Foundation,NBRF)所維護的蛋白質資訊資源中心-PIR (The Protein Information Resource)網站。另外還有與蛋白質Domain、Motif有關的網站,以及在耶魯大學的新陳代謝資料庫。 - 生物巨分子的科學視覺化 (Molecular Visualization)
科學研究成果的視覺化一直是科學研究過程中很重要的一個步驟,不僅是成果容易讓人瞭解,也有助於結果的分析。而在分析、研究生物巨分子立體結構的過程中則是不可或缺的工具了。
美國國家衛生研究院的分子模型中心(Center for Molecular Modeling, CMM)收集了全球研究分子模型的網站,從這裡開始可以到達每一個分子模型的網站。另外從英國的BSM (Biomolecular Structure and Modeling)網站,可以連結到結晶學 (crystallography)或是核磁共振(NMR)的相關網站,這二大技術是目前決定生物巨分子立體結構最重要的技術。美國加州的Scripps研究院以及在舊金山的加州大學(UCSF),也都設立了電腦圖畫實驗室,進行生物巨分子立體模型的建立。
美國伊利諾大學的理論生物物理實驗室,發展了一套電腦視覺環境系統-MDScope做為結構生物學模擬分子動態的研究工具。其中的一部份稱為VMD (Visual Molecular Dynamics),用來展示和分析蛋白質或DNA,VMD配備了很好的圖形使用者介面(Graphical User Interface, GUI),方便使用者進行操作;同時VMD也可以和虛擬實境的CAVE環境配合,觀察者戴上立體眼鏡後可以看到分子結構的立體景像,便於分析蛋白質或DNA。透過通訊介面軟體-MDComm,VMD更能將在遠端所執行的分子動態模擬結果,經由網路傳輸展現在VMD的螢幕上。[8,9]
3D虛擬實境的網站在網際網路上有很多,在此我只提出VRML應用在生物巨分子的二個網站。一個是在德國西南的達木士塔(Darmstadt)科技大學[10],在這裡可以知道PDB的檔案格式可以轉換成VRML格式,再用立體眼鏡來觀測。另一個是在法國的Laue Langevin研究院,在此可以找到xtal-3d軟體,將標準的結晶檔案格式轉換成VRML檔案格式。
在這一節的最後,我想介紹的是一個目前為止在生物界最流行的分子檢視軟體-Rasmol。這個軟體是在英國葛蘭素(Glaxo Wellcome)公司的Roger Sayle所撰寫的,美國的柏克萊大學更擴充了它的功能,可以很方便的檢視生物巨分子模型,甚至可以製作動畫。而且它是個免費的軟體,可以在不同的平台上執行[11]。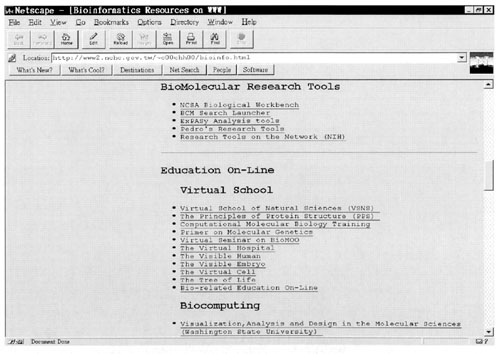
圖三 分子生物學的電腦實驗台(workbench in internet),以及網路上的虛擬學校網站。 - 網路上的生化實驗工具(BioMolecular Research Tools)
當有了蛋白質的胺基酸序列後,在設計實驗進行前,大家都會對蛋白質的基本性質(例如:分子量、等電位值pI、peptidase分解後各段peptide的分子量)、蛋白質的二級結構、膜蛋白穿透細胞膜的部位、蛋白質pattern或profile的分析、三級結構的預測;預測之前則必需進行BLAST、FASTA等等的序列比對工作。所有這些需要電腦輔助的計算,都可以在網路上找到適當的工具幫助實驗的設計。在這裡我們收集了五個著名的網站(NCSA Biology Workbench、BCM Search Launcher、ExPASy Analysis Tools、Pedro's Research Tools、Research Tools on the Network from NIH),提供結構生物學家、分子生物學家各式各樣的簡便工具,相信一定可以提高科學家們在實驗台前工作的效率。 - 網路教學 (Education On-Line)
教學是網路資源應用最重要的課題之一,在這節我們可以從網路上學習到結構生物學、分子生物學、細胞生物學、計算生物學、生物資訊學、演化學 (The Tree of Life) [12]、解剖學、發生學,以及與生命科學有關的各學門的知識;也有網站上的專題研討會-BioMOO。在網路上有完整的課程內容,例如英國倫敦大學的PPS (The Principles of Protein Structure)教學網站,就是一本完整的結構生物學教科書,並且接受註冊進行網上教學。
網路上最大的教學系統,應當是全球網路學院(The Globewide Network Academy, GNA),提供了超過15000個課程,從幼稚園到博士程度的課程都包括進去了。VSNS是GNA的一部份,主要是收集自然科學的內容,計算生物學便是這個網站收集的重點之一。 - 軟體來源 (Software Source)
近年來生物技術出現爆發性的進展,促使分析軟體的需求大增,經常可以在Nature、Science期刊的市場科技新知中得到這些資訊。有很多公司也因為擁有這些分析軟體而成立,最著名的便是GCG (Genetics Computer Group)由威斯康辛大學出來設立成公司;GCG的套裝分析軟體已經成為分子生物學家最常使用的一套軟體了。MSI (Molecular Simulations Inc.)的分子模擬軟體則是結構生物學家常用的軟體。軟體的發展各家有各家的需求與特色,NIH的軟體資訊中心是最大的收集中心,在這裡不僅可以看到各種軟體,有的更提供上機手冊,方便讀者的使用。 - 其它資源(Other Resources)
在這裡我們主要收集的是決定生物巨分子立體結構的二大技術-結晶法、核磁共振法的相關網站;尤其是與核磁共振有關的網站為主。另外有約翰霍普金斯大學的生物資訊學服務網,以及哈佛大學的生物科學虛擬圖書館。最後有清華大學生命科學所謝孟叡同學收集的,各種科學期刊的網站收集;以及呂平江教授、黃鎮剛教授所開授的生物資訊學相關資訊。 - 生物資訊學的最新發展(What's News in Bioinformatics)
生物資訊學的蓬勃發展,使得國際會議舉辦的頻率愈來愈高,這些會議的主題及舉辦地點、時間都登錄在網站上。由於國際上生物資訊人才的需求愈來愈大,不只各研究機構需要人,各大藥廠也在徵摹人才[13],因此有了專業的生物資訊報導提供最新資訊。各大資料庫及廠商也會出版自己的newsletters,說明最新的發展。根據這些報導,讀者便可以明瞭生物資訊學的走向,以及生物資訊學的應用。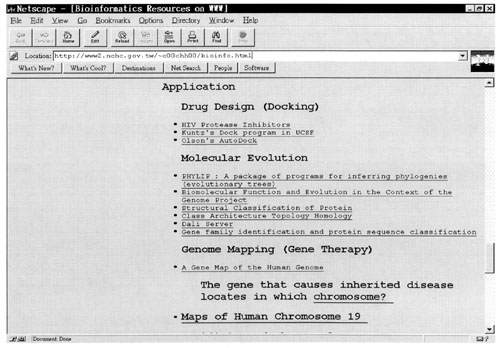
圖四 藥物設計、分子演化樹建立、基因組地圖繪製,是生物資訊學應用的一部份。 - 生物資訊學的應用 (Application)
在這個小節中,我只收集三個應用,藥物設計(Drug Design)、分子演化樹建立(Molecular Evolution)、基因組地圖繪製(Genome Mapping)的網站,最後則是幾個利用生物資訊學進行研究的研究機構,和大藥廠的網站。
現在人類面臨最大威脅的傳染病是有世紀黑死病之稱的愛滋病,而應用生物資訊學正可以加速抗愛滋病毒(anti-HIV-l)新藥的開發[14]。藥物開發的過程中,藥物與作用對象之間的三度空間的相對關係非常重要,必需要互相配對的很好,才有成為新藥的可能,這個技術就是氥ocking荂C美國加州的Scripps研究院的Olson教授[15]、以及在舊金山的加州大學的Kuntz教授[16]在這個技術的應用都有所貢獻。
將物種分類進行演化樹的建立是一門歷史久遠的學科,用來說明物種之間親疏遠近的關係。早期的分類原則是根據解剖學的知識建立起演化樹,現在則拜分子生物學之賜,有大量DNA序列的資料,科學家利用多重序列排列(multiple sequence alignment)的分析方法,建立起有分子生物學基礎的分子演化樹[17]。另外有科學家認為,蛋白質的結構決定了蛋白質的功能,因此對於蛋白質執行功能部位的三度空間結構進行比對,應該可以得到物種之間的演化關係[18] 。
遺傳疾病的診斷,最早是由觀察染色體的異常來進行診斷,因此只能得到那個染色體有異常,可能發生什麼遺傳疾病的知識。對於是那些DNA序列的突變所造成的,完全沒有概念,更談不上利用基因治療了。基因組地圖的繪製,便是找出所謂的基因地標(gene marker),定出遺傳疾病對應到染色體的那個位置,破壞的是那個蛋白質的功能,進而研究基因治療的可行性[19]。一但這個人類基因組地圖製作完成之後,人類遺傳疾病的篩選會更有效率,遺傳疾病的治療也有可能實現,將會大幅降低社會成本的支出。這個巨大的誘因,相信也是推動人類基因組解讀計劃進行的動力之一。
由於基因資料庫的內容,有巨大的市場商機,科學家可以利用生物密碼製造出任何他們可以想像得到的生物巨分子,用來做為藥物;可以改良動植物,增加糧食的產量等等。因此全球各大藥廠莫不競相投入人力與財力,發展分析軟體,甚至建立自己獨有的資料庫;近來更有DNA序列做為專利提出登記的爭議出現[20]。在這裡我們提供一些研究機構,與大藥廠的網址,讓讀者瞭解這些單位如何應用生物資訊學的資訊進行研究,搶攻目前最熱門的市場[21] 。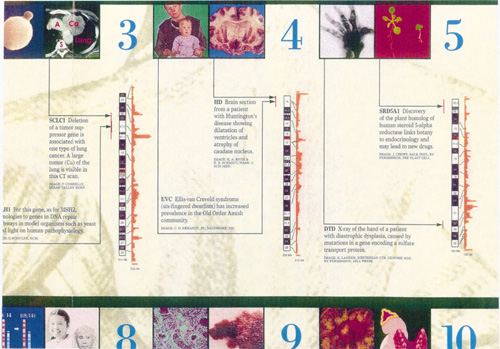
圖五 越來越多造成遺傳疾病的缺陷基因,它們在染色體上的位置被決定出來了。引起追蹤治病基因聖戰的著名的享丁頓氏舞蹈症(Huntington's disease)它的對映基因位在第四對染色體上。(圖摘錄自Science,1996,274,547-562) - 其它(others)
為了使電腦看起來會與人更親近,也為了使用的便利性,好的圖形使用者介面-GUI的設計,便會是軟體是否會流行的因素之一。因此我們收集了一些生物資訊GUI的網站,學習一下如何設計好的圖形使用者介面。
最後國內的中央研究院生命科學圖書館、清華大學生命科學所、國家衛生研究院、陽明大學等單位也都有生物資訊學的相關資訊在網路上提供。
以上是本人收集一些有關生物資訊學、計算生物學相關資訊的網站,其它還有更多更好的網站被遺落了,為了補救這部份的缺失,只好請讀者使用搜索引擎(search engien)進行網路搜尋了。中文搜索引擎最著名的便是蕃薯藤站,國外則是Yahoo網站,高速電腦中心也收集了一些搜索引擎,讀者也可以利用。
結論
由於生物科技的進步,使得生物資料庫的資料量暴增;同時期電腦的計算能力、硬碟容量也有巨大的進步。使得生物資訊學、計算生物學在這個時候適時的誕生了,也引出了許多研究的題目(例如:資料庫的建立與整合、序列的比對與分析、基因全序列的定序與基因組地圖建構、蛋白質結構和功能的分析與預測、分子模型的建立與新藥的設計、演化樹的建立等等),吸引了很多科學家投入研究的行列。
而在資料庫的資料量愈來愈多時,資料搜尋的技術將會成為實驗技術的一部份,因此如何快速取得有用的資料?如何善用資料?如何整合資料創造出新的知識?將成為接下來所需要面臨的重要課題,在即將進入生物科技世代的廿一世紀-基因世紀,企盼國內能有更多研究工作者加入生物資訊學的領域共同打拼。
參考資料
- Kestenbaum, D. “Cloning Plan Spawns Ethics Debate”?(1998) Science, 279, 315. ; Gina Kolata“基因複製:從複製羊桃麗看人類的未來”(1998),遠流出版社(洪蘭譯)。
- Copper, N. G, ed. “The Human Genome Project”?(1994) University Science Books.
- Benson, D. A., M. S. Boguski, D. J. Lipman & J. Ostell “GenBank”?(1997) Nucleic Acids Res., 25, 1-6. ; Stoesser, G., P. Sterk, M. A. Tuli, P. J. Stoehr & G. N. Cameron 涆he EMBL Nucleotide Sequence Database?(1997) Nucleic Acids Res., 25, 7-13. ; Tateno, T. & T. Gojobori 氥NA Data Bank of Japan in the age of information biology?(1997) Nucleic Acids Res., 25, 14-17.
- Sussman, J. L. “Bridging the gap”?(1997) Nature Structural Bio., 4, 517.
- Hubbard, T. J. P., A. G. Murzin, S. E. Brenner & C. Chothia “SCOP: a Structure Classification of Proteins database”?(1997) Nucleic Acids Res. 25, 236-239.
- Holm L. & C. Sander “Mapping the Protein Universe”?(1996) Science, 273, 595-602.
- Pennisi, E. “Taking a Structured Approach to Understanding Proteins”?(1998) Science, 279, 978-979.
- Nelson, M., et al. “MDScope - a visual computing environment for structural biology”?(1995) Comp. Phys. Comm., 91, 111-133.
- Humphrey, W., A. Dalke & K. Schulten “VMD: Visual Molecular Dyamics”?(1996) J. Mol. Graphics, 14, 33-38.
- Vollhardt, H. & J. Brickmann ?“3D Molecular Graphics on the World Wide Web”?in Pacific Symposium on Biocomputing'96 p663-673 (1996) World Scientific Publishing, Singapore.
- 謝昌煥、黃鎮剛 “Rasmol EZ-GUI圖形使用者界面程式語言 Tcl/Tk的應用”?(1997)高速計算世界,Vo15, No3, 26-29.
- Morell, V. “Web-Crawling Up the Tree of Life”?(1996) Science, 273, 568-570.
- Ruediger, N. “Bioinformatics: New Frontier Calls Young Scientists”?(1996) Science, 273, 265.
- Fishman, R. H. B. “Bioinformatics speeds HIV-1 drug development”?(1996) Lancet, 348, 1648.
- Morris, G. M., D. S. Goodsell, R. Huey & A. J. Olson “Distributed automated docking of flexible ligands to proteins: Parallel applications of AuotDock 2.4”?(1996) J. Computer-Aided Molecular Desing, 10, 293-304.
- Kuntz, I. D. “Structure-Based Strategies for Drug Desing and Discovery”?(1992) Science, 257, 1078-1082.
- Hein, J. “Unified Approach to Alignment and Phylogenies”?(1996) Methods. in Enzymology, 183, 626-645.
- Johnson, M. S., A. Sali & T. L. Blundell “Phylogenetic Relationships from Three-Dimensional Protein Structures”?(1996) Methods. in Enzymology, 183, 670-690.
- Speed, T. & M. S. Waterman ed. “Genetic Mapping and DNA Sequencing”?(1996) Springer-Verlag New York, Inc.
- Fred Warshofsky “專利怪獸:生物科技”?(1997)專利奇兵第八章,時報文化出版社(張禹治譯)。
- Gershon D., B. W. Sobral, B. Horton, P. Wickware, H. Gavaghan & M. Strobl “Bioinformatics in a post-genomics age”?(1997) Nature, 389, 417-422.
(本文作者現任國家高速電腦中心應用研究一組副研究員)